- Teil 1 · Sie sind hierErfassen · Modellieren · Auflösen
- Teil 2Vereinheitlichen · Segmentieren · Entscheiden · Aktivieren
- Teil 3Steuern · Messen · Warehouse · KI-Agenten
Omnichannel ist keine Kanalstrategie. Es ist eine Frage zu einem Objekt: liest jeder Kanal dasselbe Kundenprofil?
- 7 TageDer Zwischenspeicher, über den alle ihre Dateien übergeben, löscht sie nach festem Plan. Er ist kein Speicher.
- FixDie primäre Identität eines profilaktivierten Schemas lässt sich nach dem ersten Produktivladen nicht mehr ändern. Es ist die eine Entscheidung, die Sie nicht zurücknehmen können.
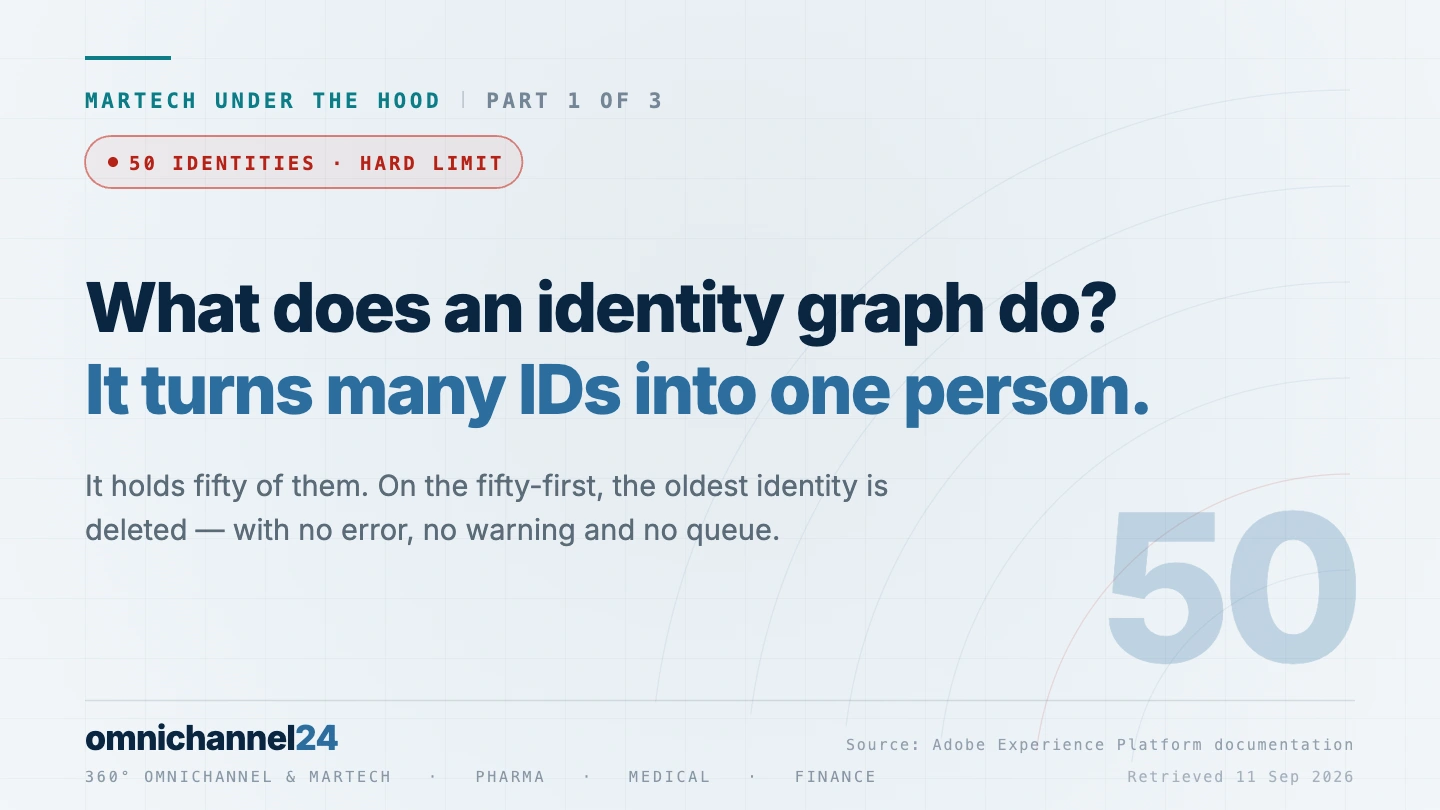
- 50Ein Identity Graph hält fünfzig Identitäten, dann löscht er die älteste, um Platz zu schaffen. Es wird kein Fehler ausgelöst, und das Profil fällt aus der Segmentierung.
30 Sekunden bis hierhin · 4 Minuten für die drei Stationen.
Jedes Omnichannel-Programm beginnt mit derselben Folie: der Kunde in der Mitte, die Kanäle drumherum angeordnet, Pfeile nach innen. Es ist eine gute Folie. Sie beschreibt ein Ergebnis, kein System – und genau in dieser Lücke bleiben die meisten Programme still stecken.
Hier ist der Test, der beides trennt. Multichannel und Omnichannel unterscheiden sich an genau einer Stelle: ob jeder Kanal dasselbe Profil liest, oder ob jeder Kanal seine eigene Liste führt. Alles andere – die Pfeile, das Wort „nahtlos“, der Kunde in der Mitte – folgt aus dieser einen architektonischen Tatsache. Wenn Ihre E-Mail-Plattform eine Liste hält, Ihre Web-Personalisierung eine zweite und Ihr Callcenter eine dritte, betreiben Sie Multichannel mit besserem Vokabular.
Alle Kanäle dasselbe Profil lesen zu lassen ist keine Beschaffungsentscheidung. Es sind neun davon, jede mit einer technischen Konsequenz, die achtzehn Monate später auftaucht. Diese Serie geht alle neun durch, mit Adobe Experience Platform als durchgerechnetem Beispiel – nicht weil die Antwort immer Adobe heißt, sondern weil Adobe seine Grenzen öffentlich dokumentiert, und dokumentierte Grenzen sind die einzige Möglichkeit, ehrlich darüber zu sprechen. Jede Zahl verlinkt auf die Seite, aus der sie stammt. Teil 1 nimmt die ersten drei – Erfassung, Datenmodell und Identity Resolution – die Stationen, die darüber entscheiden, ob Sie überhaupt einen Kunden haben, und den Identity Graph, an dem sie entweder halten oder still aufhören zu halten.
Vier Rollen in einem Unternehmen meinen vier verschiedene Dinge, wenn sie „Omnichannel“ sagen – diese vier Antworten haben wir separat aufgeschlüsselt. Dieser Artikel ist die Schicht unter allen vieren.
Batch-Ingestion bewegt Dateien, Streaming-Ingestion bewegt Events – und das sind nicht zwei Geschwindigkeiten derselben Sache. Sie landen in unterschiedlichen Speichern mit unterschiedlichen Grenzen: Streaming ins Profil ist bei 1.500 Anfragen pro Sekunde gedeckelt, in den Data Lake bei 4.000–5.000. Der schnellere Weg ist der schmalere. Und die Data Landing Zone, der Zwischenspeicher, über den die meisten Teams ihre Dateien übergeben, löscht alles nach sieben Tagen.
Quelle: Data ingestion guardrails
XDM setzt ein Schema aus einer Klasse plus Feldgruppen zusammen, und die Klasse entscheidet, ob die Daten Dinge beschreiben, wie sie sind, oder Dinge, wie sie passiert sind. Schema-Evolution ist rein additiv: Sie dürfen Felder hinzufügen, nie entfernen oder umbenennen. Ein Punkt auf der Verbotsliste wiegt schwerer als der Rest – die primäre Identität eines profilaktivierten Schemas zu ändern, sobald Daten geladen wurden.
Quelle: XDM schema composition
Identity Service verknüpft die Identifikatoren eines Kunden zu einem Identity Graph. Der Graph hält fünfzig. Bei der einundfünfzigsten wird die älteste Identität gelöscht, first in, first out – Cookie-Identifikatoren vor dauerhaften – und ein Profil oberhalb der Grenze ist von Segmentierung, Exporten und Lookups ausgeschlossen. Namespace-Priorität schützt Sie nicht, und ein bereits kollabierter Graph wird erst repariert, wenn er das nächste Mal aktualisiert wird.
Quelle: Identity Service guardrails
01 Erfassen02 Modellieren03 Auflösen
Der Stack, nicht das Werkzeug
Die erste Verwechslung, die aus dem Weg muss, ist der Unterschied zwischen einer Plattform und einer darauf gebauten Anwendung.
Adobe führt als Anwendungen auf Experience Platform auf: Real-Time CDP, Real-Time CDP B2B Edition, Journey Optimizer, Customer Journey Analytics, Journey Orchestration und Mix Modeler. Die Plattform darunter übernimmt Ingestion, Datenmodell, Identität, Profil, Zielgruppen, Governance und Aktivierung. Die Anwendungen konsumieren das alles.
Das ist wichtig, weil Kaufentscheidungen intern anders beschrieben werden. „Wir haben Journey Optimizer gekauft“ beschreibt eine Anwendung. Es sagt nichts darüber, ob die Daten darunter modelliert, aufgelöst, gesteuert oder aktivierbar sind – und diese vier entscheiden, ob die Anwendung überhaupt etwas Brauchbares tut. Dieselbe Trennung gibt es in jedem Stack, unter anderen Namen und in anderer Anordnung.
Ein Begriff noch vor den Stationen, weil er an fast jeder wiederkehrt: die Sandbox. Sie ist die Isolationsgrenze – eine virtuelle Partition der Plattform mit eigenen Daten, eigener Konfiguration, eigenen Grenzen. Fast jede Zahl in diesem Artikel ist pro Sandbox definiert. Sie ist die folgenreichste unsichtbare Linie in der Architektur, und sie taucht auf keinem der Diagramme auf.
Station 1 – Erfassen
Daten kommen auf zwei Wegen an, und das sind nicht zwei Geschwindigkeiten derselben Sache. Es sind zwei Wege in zwei verschiedene Speicher mit zwei verschiedenen Sets von Grenzen.
Batch-Ingestion bewegt Dateien. Streaming-Ingestion bewegt Events. Die veröffentlichten Zeiten liegen weiter auseinander, als das Wort „Streaming“ vermuten lässt.
- Streaming ins Profil. Adobe veröffentlicht ein Service Level von unter 15 Minuten im 95. Perzentil für B2C-Ingestion und unter 30 Minuten für B2B.
- Was der Troubleshooting-Leitfaden beobachtet. In der Praxis sind gestreamte Events „in der Regel in unter 60 Sekunden im Real-Time Customer Profile sichtbar“.
- Streaming in den Data Lake. Derselbe Weg ist mit unter 60 Minuten dokumentiert.
Beachten Sie, was das bedeutet: die Sekundenangabe ist eine Beobachtung aus Adobes Troubleshooting-Leitfaden, keine veröffentlichte Latenz, während die Stunde in den analytischen Speicher dokumentiert ist. Zwei Antworten auf „haben wir diese Daten schon“, beide richtig, je nachdem wer fragt.
Erfassen
Was ankommt, und auf welchem der beiden Wege es reist.
Batch- und Streaming-IngestionDie Durchsatzzahlen laufen in dieselbe Richtung. Adobes Performance-Guardrail für Streaming ins Profil und in die Streaming-Segmentierung liegt bei 1.500 Anfragen pro Sekunde; in den Data Lake bei 4.000–5.000. Der schnellere Weg ist der schmalere. Das ist kein Fehler, das ist der Handel – Echtzeitverarbeitung kostet Reserve.
Ihr Team nutzt die Data Landing Zone als Übergabepunkt zwischen zwei Systemen. Wie lange bleibt eine Datei dort liegen?
Sieben Tage, ohne Ausnahme: „Experience Platform enforces a strict seven-day expiration time on all files and folders uploaded to a Data Landing Zone container. All files and folders are deleted after seven days.“ Es ist ein Zwischenspeicher, kein Speicher – und dieser Unterschied hat schon mehr als einen Übergabeprozess lautlos beendet.
Jede Übergabe, die auf der Annahme beruht, eine Datei warte bis sie abgeholt wird, trägt eine Sieben-Tage-Frist, die niemand aufgeschrieben hat. Sie zeigt sich als Lücke in einem Report am achten Tag, nicht als Fehler in einem Ingestion-Log.
Zwei weitere Zahlen, die in jeden Implementierungsplan gehören.
- Batch ins Profil. Adobes Performance-Guardrail liegt bei 90 kombinierten Profil- und Event-Batches pro Sandbox und Tag – genug für eine geplante Architektur, nicht genug für eine, die Batch als Wiederholungsmechanismus behandelt.
- Der Zwischenspeicher. Die Data Landing Zone, die viele Teams als informellen Übergabepunkt zwischen Systemen nutzen, löscht alles nach sieben Tagen: „Experience Platform enforces a strict seven-day expiration time on all files and folders uploaded to a Data Landing Zone container.“
Ihr Zwischenspeicher ist kein Speicher.
Eine Anmerkung zu Adobes eigener Dokumentation an dieser Stelle, weil sie lehrreich ist. Die Guardrails-Seite nennt maximal 25.000 Dateien und 1 TB pro Batch. Die Übersichtsseite zur Batch-Ingestion nennt für dasselbe 1.500 Dateien und 100 GB. Beide sind aktuell. Wenn zwei Seiten eines Herstellers sich widersprechen, ist die praktische Antwort, deutlich innerhalb der kleineren Zahl zu entwerfen und gegen den eigenen Tenant zu prüfen statt gegen irgendeinen Artikel – auch diesen.
Bevor irgendjemand über Journeys spricht, lasse ich mir das Quellenverzeichnis mit zwei zusätzlichen Spalten geben: Batch oder Streaming, und der Name der Person, die das entschieden hat. Dann halte ich diese Spalte gegen die Latenz, die jeder nachgelagerte Anwendungsfall voraussetzt. Wo beide auseinandergehen, habe ich das Problem gefunden, bevor die erste Journey gebaut ist – und an dem Punkt ist es ein Nachmittag Arbeit statt einer Migration.
Christopher Dettinger · MarTech- und Omnichannel-Architekt
- Sie wissen, welche Ihrer Quellen Batch sind und welche Streaming.
- Diese Aufteilung wurde bewusst entschieden – nicht danach, welche Quelle sich am leichtesten anschließen ließ.
- Alle, die Dateien über den Zwischenspeicher übergeben, wissen, dass er kein Speicher ist.
Station 2 – Modellieren
Das ist die Station, die Teams übereilen, und die einzige in der Kette, die faktisch unumkehrbar ist.
Adobes Datenmodell ist XDM – das Experience Data Model. Seine Kompositionsregel steht als Formel da: „Class + Schema Field Group* = XDM Schema“. Die Klasse entscheidet, ob ein Schema Dinge beschreibt, wie sie sind (Record-Daten – ein Kunde, ein Produkt, ein Konto) oder Dinge, wie sie passiert sind (Zeitreihendaten – ein Klick, ein Kauf, eine geöffnete E-Mail). Diese Wahl wird einmal getroffen, an der Klasse, und alles Nachgelagerte erbt sie.
Modellieren
Das Schema, dem jeder eingehende Datensatz entsprechen muss.
XDM · Experience Data ModelSchema-Evolution folgt dem, was Adobe ein rein additives Versionierungsprinzip nennt: Änderungen sind nur erlaubt, wenn sie nicht zerstörend sind. Sie dürfen Felder hinzufügen. Sie dürfen ein Pflichtfeld optional machen. Sie dürfen ein Feld nicht entfernen, umbenennen, verschieben, eine Werteinschränkung lockern, ein Schema löschen oder seine Teilnahme am Profil deaktivieren. Sobald echte Daten geladen wurden, werden „die Regeln der Schema-Evolution strikt durchgesetzt“, und Felder „werden in allen XDM-Schemas, in denen sie referenziert sind, nicht mehr editierbar“.
Was können Sie nach dem ersten Produktivladen noch ändern?
Nur Ergänzungen. Adobe setzt ein rein additives Versionierungsprinzip durch: Sie dürfen Felder hinzufügen und Pflichtfelder optional machen. Sie dürfen ein Feld nicht umbenennen, entfernen oder verschieben – und die Verbotsliste nennt ausdrücklich „changing primary identity on Profile-enabled schemas with ingested data“. Der Name eines Feldes ist noch früher fix, ab dem Speichern des Schemas.
Das ist die einzige Station der Kette, an der eine falsche Entscheidung nicht an Ort und Stelle korrigiert werden kann. Zielgruppen, Journeys und Destinations lassen sich neu bauen. Eine primäre Identität lässt sich nur migrieren – und die Migration berührt jedes Objekt, das von ihr abhängt.
Ein Punkt auf der Verbotsliste verdient es, zweimal gelesen zu werden: „Changing primary identity on Profile-enabled schemas with ingested data.“
Die primäre Identität ist das Feld, das sagt: diese Zeile ist eine Person, und zwar diese. Sie zu wählen ist eine Modellierungsentscheidung, die früh fällt, oft von der Person, die dem Quellsystem am nächsten ist, oft bevor irgendjemand darüber nachgedacht hat, wie die Identitätsstrategie in drei Jahren aussieht. Nach der ersten Zeile Produktivdaten ist sie fix.
Alles andere lässt sich neu bauen. Das Datenmodell muss migriert werden.
Alles andere in diesem Artikel lässt sich neu bauen. Zielgruppen lassen sich umschreiben, Destinations neu verbinden, Policies aktivieren, Journeys umbauen. Das Datenmodell nicht – nicht ohne eine Migration, die jedes nachgelagerte Objekt berührt. Es verdient einen entsprechenden Anteil der Projektaufmerksamkeit, was ungefähr das Gegenteil dessen ist, was es üblicherweise bekommt.
Für jedes profilaktivierte Schema stelle ich zwei Fragen und schreibe die Antworten auf: wem gehört die primäre Identität, und an welchem Datum hat diese Person sie freigegeben. Nicht der Integrationsentwickler, nicht die Agentur – jemand, der in drei Jahren noch im Raum sitzt. Fehlt eine der beiden Antworten, stoppe ich das Schema-Review dort statt nach dem ersten Produktivladen, weil das der Punkt ist, hinter dem kein späteres Projekt es rückgängig macht.
Christopher Dettinger · MarTech- und Omnichannel-Architekt
- Jedes profilaktivierte Schema hat einen benannten Verantwortlichen für seine primäre Identität.
- Diese Person versteht sowohl die Quellsysteme als auch die Identitätsstrategie auf drei Jahre.
- Die Freigabe liegt vor dem ersten Produktivladen vor, nicht danach.
Station 3 – Auflösen
Hier funktioniert Omnichannel entweder, oder es scheitert lautlos. Nicht laut. Lautlos.
Ein Kunde ist nicht ein Identifikator. Er ist ein Browser-Cookie auf einem Laptop, ein zweites auf einem Telefon, eine App-Installations-ID, eine gehashte E-Mail aus einem Newsletter, ein CRM-Datensatz, eine Kundennummer, ein zweiter Browser, nachdem er letzten Monat die Cookies gelöscht hat. Identity Resolution ist der Prozess, zu entscheiden, dass all das zu einer Person gehört.
Auflösen
Entscheiden, welche der vielen Identifikatoren eines Kunden eine Person sind.
Identity ServiceAdobes Identity Service tut das, indem er einen Identity Graph baut – die Menge der Identitäten, die einen Kunden repräsentieren. Jeder Identifikator sitzt in einem Identity Namespace: Email, Phone, CRMID, ECID und jeder eigene Namespace, den Sie definieren. Es gibt keine Grenze dafür, wie viele eigene Namespaces Sie anlegen können.
Es gibt allerdings eine Grenze für den Graph.
Ein Identity Graph läuft voll. Was passiert mit der einundfünfzigsten Identität?
Ein Graph hält maximal 50 Identitäten. Bei der einundfünfzigsten wendet Identity Service ein First-in-first-out-Verfahren an und löscht die älteste – Cookie-Identifikatoren vor dauerhaften. Es gibt keinen Fehler und keine Warnung, und ein Profil oberhalb der Grenze ist von Segmentierung, Exporten und Lookups ausgeschlossen.
Nichts in der Oberfläche ändert sich, wenn das passiert. Das Profil taucht in Segmentierung, Exporten und Lookups nicht mehr auf, und die Zahl im Kampagnenreport ist still niedriger als sie sein sollte. Der einzige Weg, es kommen zu sehen, ist die Verteilung der Identitäten pro Graph anzuschauen, bevor sie fünfzig erreicht.
Fünfzig
Fünfzig klingt großzügig, bis man einen echten Haushalt zählt. Vier Personen. Drei Geräte pro Person. Zwei Browser pro Gerät. Cookie-Löschungen alle paar Wochen, jede erzeugt eine frische ECID. Ein gemeinsames Tablet, das die Identitäten zweier Familienmitglieder in einen Graph zieht. Ein Arbeitslaptop und ein privater. Dazu eine Servicebearbeitung, die eine Fall-ID als Namespace schreibt, und ein Kundenbindungsprogramm, das seine eigene schreibt.
Fünfzig kommt schneller, als irgendjemand plant. Und was dann passiert, lohnt sich wörtlich zu zitieren: wenn ein Graph mit 50 verknüpften Identitäten aktualisiert wird, wendet Identity Service „a ‘first-in, first-out’ mechanism“ an und „deletes the oldest identity to make space for the newest identity for this graph“.
Neunundvierzig Identitäten, die älteste links. Ein Haushalt, ein paar Cookie-Löschungen, ein gemeinsames Tablet, eine Kundennummer. Bisher ist nichts Ungewöhnliches passiert.
Fünfzig. Der Graph ist voll. Nichts in der Oberfläche sagt das.
Die einundfünfzigste ist nicht gescheitert. Identity Service hat die älteste Identität gelöscht – eine Cookie-ID – um Platz zu schaffen. Kein Fehler, keine Warteschlange, keine Warnung.
Quelle: Identity Service guardrails · abgerufen am 11.09.2026
Die Verdrängung ist nicht zufällig. Sie priorisiert nach Identitätstyp – Cookie-ID zuerst, dann Geräte-ID, dann die dauerhaften Personenidentifikatoren, zusammengefasst als Cross-Device-ID, E-Mail und Telefon – und innerhalb eines Typs nach dem Zeitstempel der Identität. Der Entwurf ist sinnvoll: wirf die billigen Identifikatoren weg, bevor du die dauerhaften wegwirfst.
Beachten Sie aber die zwei Dinge, die er nicht tut. Er warnt Sie nicht. Und Namespace-Priorität schützt Sie nicht: Adobe stellt unmissverständlich fest, dass „namespace priority does not affect graph behavior when the limit of 50 identities per graph is reached“. Die Priorität, die Sie konfiguriert haben, regelt, welche Verknüpfungen einen Konflikt überleben. Sie regelt nicht, welche Identitäten die Obergrenze überleben.
Die kleinen Dinge, die einen Identity Graph zerlegen
- Identity Service unterscheidet Groß- und Kleinschreibung. Adobes eigenes Beispiel: „abc@gmail.com and ABC@GMAIL.COM would be treated as two separate Email identities.“ Wenn ein Quellsystem E-Mail-Adressen in Großbuchstaben schreibt und ein anderes nicht, bauen Sie keinen Graph. Sie bauen zwei, und die werden nie zusammenfinden.
- ECIDs haben ein Format. Genau 38 Zeichen, nur Ziffern. Datensätze, die das nicht erfüllen, werden bei der Ingestion übersprungen. Identitätswerte dürfen generell 1.024 Zeichen nicht überschreiten und nicht die Zeichenketten „null“, „anonymous“, „invalid“ oder leer sein.
- Sie bekommen drei eindeutige Namespaces. Einen Namespace als eindeutig zu deklarieren bedeutet, dass ein Graph nur eine Identität in diesem Namespace halten kann – der Mechanismus, der verhindert, dass eine CRM-ID in eine andere kollabiert. Sie können maximal drei konfigurieren, und Änderungen brauchen bis zu 24 Stunden, bis sie greifen.
Die Reparaturregel
Wenn ein Graph kollabiert ist – wenn zwei Personen wegen eines gemeinsamen Geräts oder eines schlechten Schlüssels zu einem Profil verschmolzen sind – repariert eine geänderte Konfiguration das nicht rückwirkend:
Ein kollabierter Graph für einen Kunden, der seit der Korrektur nicht aktiv war, bleibt kollabiert. Ihre Konfiguration ist richtig. Ihr Dashboard ist grün. Das Profil ist weiterhin falsch, und es bleibt falsch, bis diese Person wiederkommt.
Der Graph scheitert nicht laut. Er scheitert lautlos.
Das ist, was „lautlos scheitern“ in der Praxis heißt. Es gibt keinen Fehlerzustand, keine Warteschlange abgelehnter Datensätze, keine Warnung. Es gibt ein Profil, das aufgehört hat ansprechbar zu sein, und eine Zahl in einem Report, die still niedriger ist als sie sein sollte.
Ich lasse mir die Verteilung der Identitäten pro Graph geben, nicht den Durchschnitt – ein Durchschnitt sagt nichts über eine Obergrenze. Was ich sehen will, ist der Rand: wie viele Profile bereits über vierzig liegen, denn das sind die, die sich dem Punkt nähern, an dem sie nicht mehr ansprechbar sind. Wenn niemand diese Zahl liefern kann, ist genau das der Befund, und er steht im Report vor allem anderen.
Christopher Dettinger · MarTech- und Omnichannel-Architekt
Eine Variante davon haben wir im Detail durchgespielt (auf Englisch) – ein authentifiziertes Portal, in dem ECID, CRM-Identität und der gestreamte Consent-Datensatz zusammenpassen müssen, bevor ein Arzt die richtige Seite sieht.
- Sie wissen, welcher Namespace Ihre Personenidentität ist und ob er als eindeutig deklariert ist.
- Sie wissen, wie viele Identitäten Ihre Graphen heute tragen – die Verteilung, nicht nur den Durchschnitt.
- Die Normalisierung von Groß- und Kleinschreibung wurde über jede Quelle geprüft, die eine E-Mail-Adresse schreibt.
Was Teil 2 behandelt
Die drei Stationen in diesem Artikel entscheiden, ob Sie überhaupt einen Kunden haben: ob die Daten ankommen, ob sie so modelliert sind, dass man sie nutzen kann, und ob die Fragmente sich zu einer Person auflösen. Macht man die falsch, kann nichts Nachgelagertes das ausgleichen – eine Zielgruppe auf einem kollabierten Identity Graph ist falsch, egal wie gut die Kampagne ist.
Teil 2 nimmt die nächsten vier: Vereinheitlichen, wo aus Fragmenten ein Profil mit Verfallsdatum wird; Segmentieren, wo sich „Echtzeit“ als Eigenschaft der Regel statt der Plattform herausstellt; Entscheiden, wo die Grenze nicht die Kapazität ist, sondern was eine Entscheidung sehen kann; und Aktivieren, wo die Zeitannahmen aus Kampagnenplänen auf die dokumentierte Wirklichkeit treffen. Teil 3 schließt mit Governance, Messung, der Warehouse-Frage und dem, was KI-Agenten verändern.
Häufige Fragen
Was ist der technische Unterschied zwischen Multichannel und Omnichannel?
Ob jeder Kanal dasselbe Kundenprofil liest oder jeder seine eigene Liste führt. In einem Multichannel-Stack halten die E-Mail-Plattform, die Web-Personalisierung und das Contact Center jeweils ihre eigene Kopie der Zielgruppe. In einem Omnichannel-Stack lesen alle drei ein Profil, aufgelöst aus einem Identity Graph. Alles andere – konsistente Botschaften, wiedererkannte Kunden, durchgängige Journeys – ist eine Folge dieses einen strukturellen Unterschieds.
Wie funktioniert Identity Resolution in einer CDP?
Jeder Identifikator, den ein Kunde erzeugt – Cookie-IDs, Geräte-IDs, gehashte E-Mails, CRM-Datensätze – wird in einen Namespace gelegt und zu einem Identity Graph verknüpft, der eine Person repräsentiert. Verknüpfungen entstehen, wenn ein gemeinsames Signal zwei Identifikatoren verbindet, etwa ein Login, das ein Browser-Cookie an ein bekanntes Konto bindet. Die Qualität der Auflösung hängt vollständig von der Qualität und Konsistenz der Schlüssel ab, die Ihre Quellsysteme schreiben.
Was ist ein Identity Graph, und hat er eine Grenze?
Ein Identity Graph ist die Menge der Identitäten, die einen Kunden repräsentieren. Er hat eine dokumentierte Obergrenze: Adobe deckelt den Graph eines einzelnen Profils bei 50 Identitäten, und ein Profil darüber ist von Segmentierung, Exporten und Lookups ausgeschlossen. Wird ein voller Graph aktualisiert, wird zuerst die älteste Identität gelöscht – Cookie-Identifikatoren vor dauerhaften. Es wird kein Fehler ausgelöst.
Was braucht es tatsächlich, um Omnichannel-Marketing zu betreiben?
Neun Fähigkeiten, die in Reihe funktionieren müssen: Erfassung, ein Datenmodell, Identity Resolution, ein vereinheitlichtes Profil, Segmentierung, Decisioning, Aktivierung, Governance und Messung. Keine lässt sich überspringen und keine als fertiges Produkt kaufen – jede ist eine Reihe von Entscheidungen mit dokumentierten Grenzen daran. Die Plattform ist der einfache Teil. Die neun Entscheidungen sind die Arbeit.
Ein Identity Graph scheitert selten zum Go-live. Er scheitert achtzehn Monate später, wenn eine Namespace-Entscheidung, die niemand dokumentiert hat, anfängt Profile zu verlieren. Wenn vorher jemand einen zweiten Blick darauf werfen soll – genau das mache ich, für Teams in Pharma, Medical und Finance.
Schreib mir kurz →Weiterlesen: Was Omnichannel-Marketing bedeutet – vier Rollen, vier Antworten · HCP-Portal, Teil 2 – die Daten laufen eine Berechtigungskette entlang (auf Englisch).
Die Zahlen in diesem Artikel stammen aus Adobes öffentlicher Dokumentation und verlinken auf ihre Quelle; alle Seiten wurden am 11. September 2026 abgerufen. Guardrails ändern sich mit Releases, und Adobe unterscheidet zwischen systemseitig erzwungenen Grenzen und Performance-Empfehlungen – prüfen Sie gegen Ihren eigenen Tenant, bevor Sie auf eine Zahl hin entwerfen, auch auf diese. Quellen: Data ingestion guardrails · Streaming ingestion overview · Data Landing Zone · XDM schema composition · Identity Service guardrails · Identity Service overview · Real-Time Customer Profile guardrails · Identity Graph Linking Rules. Adobe, Adobe Experience Platform und Adobe Real-Time CDP sind Marken von Adobe Inc. Dies ist eine unabhängige Analyse; keine Partnerschaft mit oder Billigung durch Adobe.